
SEO-Tools gibt es genug. Trotzdem entwickle ich seit einiger Zeit ein eigenes.
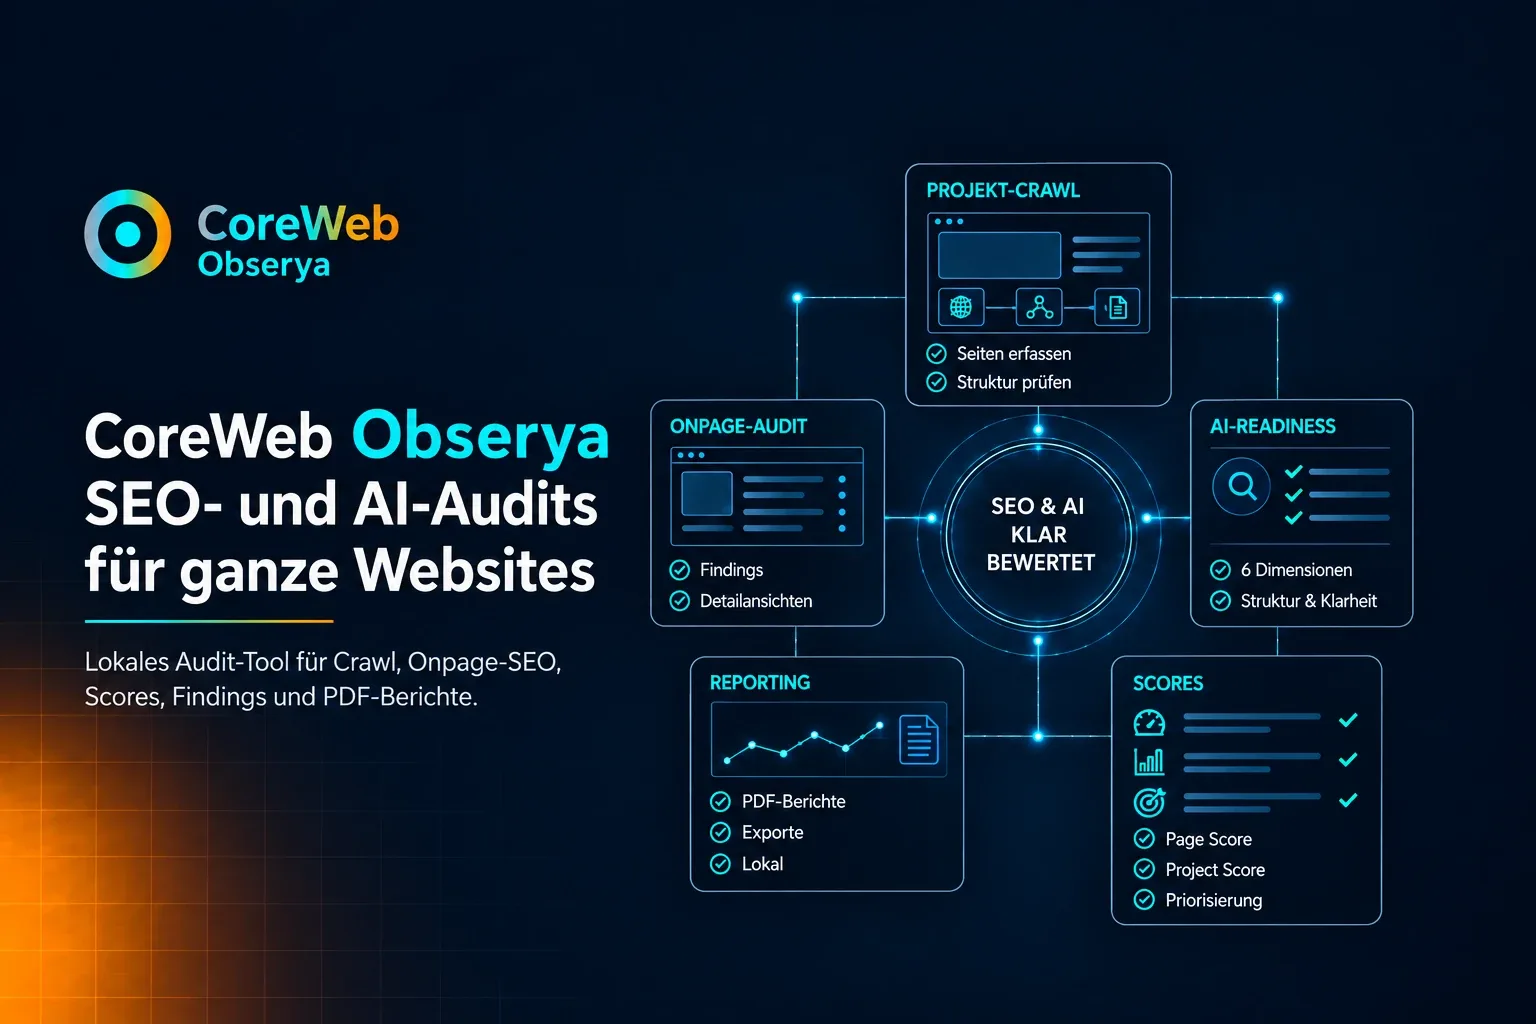
Obserya crawlt Websites projektweit, prüft technisches und inhaltliches On-Page-SEO und bewertet zusätzlich, wie verständlich eine Website für KI-gestützte Such- und Antwortsysteme aufgebaut ist.
Der aktuelle Entwicklungsstand ist Obserya v0.6.0-alpha.1 für Windows. Findings lassen sich bis zur betroffenen URL verfolgen. Audit-Berichte und technische Exporte werden direkt aus der Desktop-Anwendung erzeugt. Das ist der Stand der internen Alpha, keine öffentlich freigegebene Beta.
Das Produkt ist noch nicht fertig. Es ist aber auch keine Idee mehr, die nur aus einer Figma-Datei, drei Screenshots und einer optimistischen Präsentation besteht.
Den Produktüberblick gibt es auf der Obserya-Website. Hier erkläre ich, wie der Audit arbeitet und welche Grenzen der aktuelle Stand hat.
Obserya im Überblick
Im aktuellen Alpha-Stand implementiert
- projektweiter HTML-Crawl und On-Page-Audit
- Seitenklassifizierung, Findings, Scores und Detailansichten
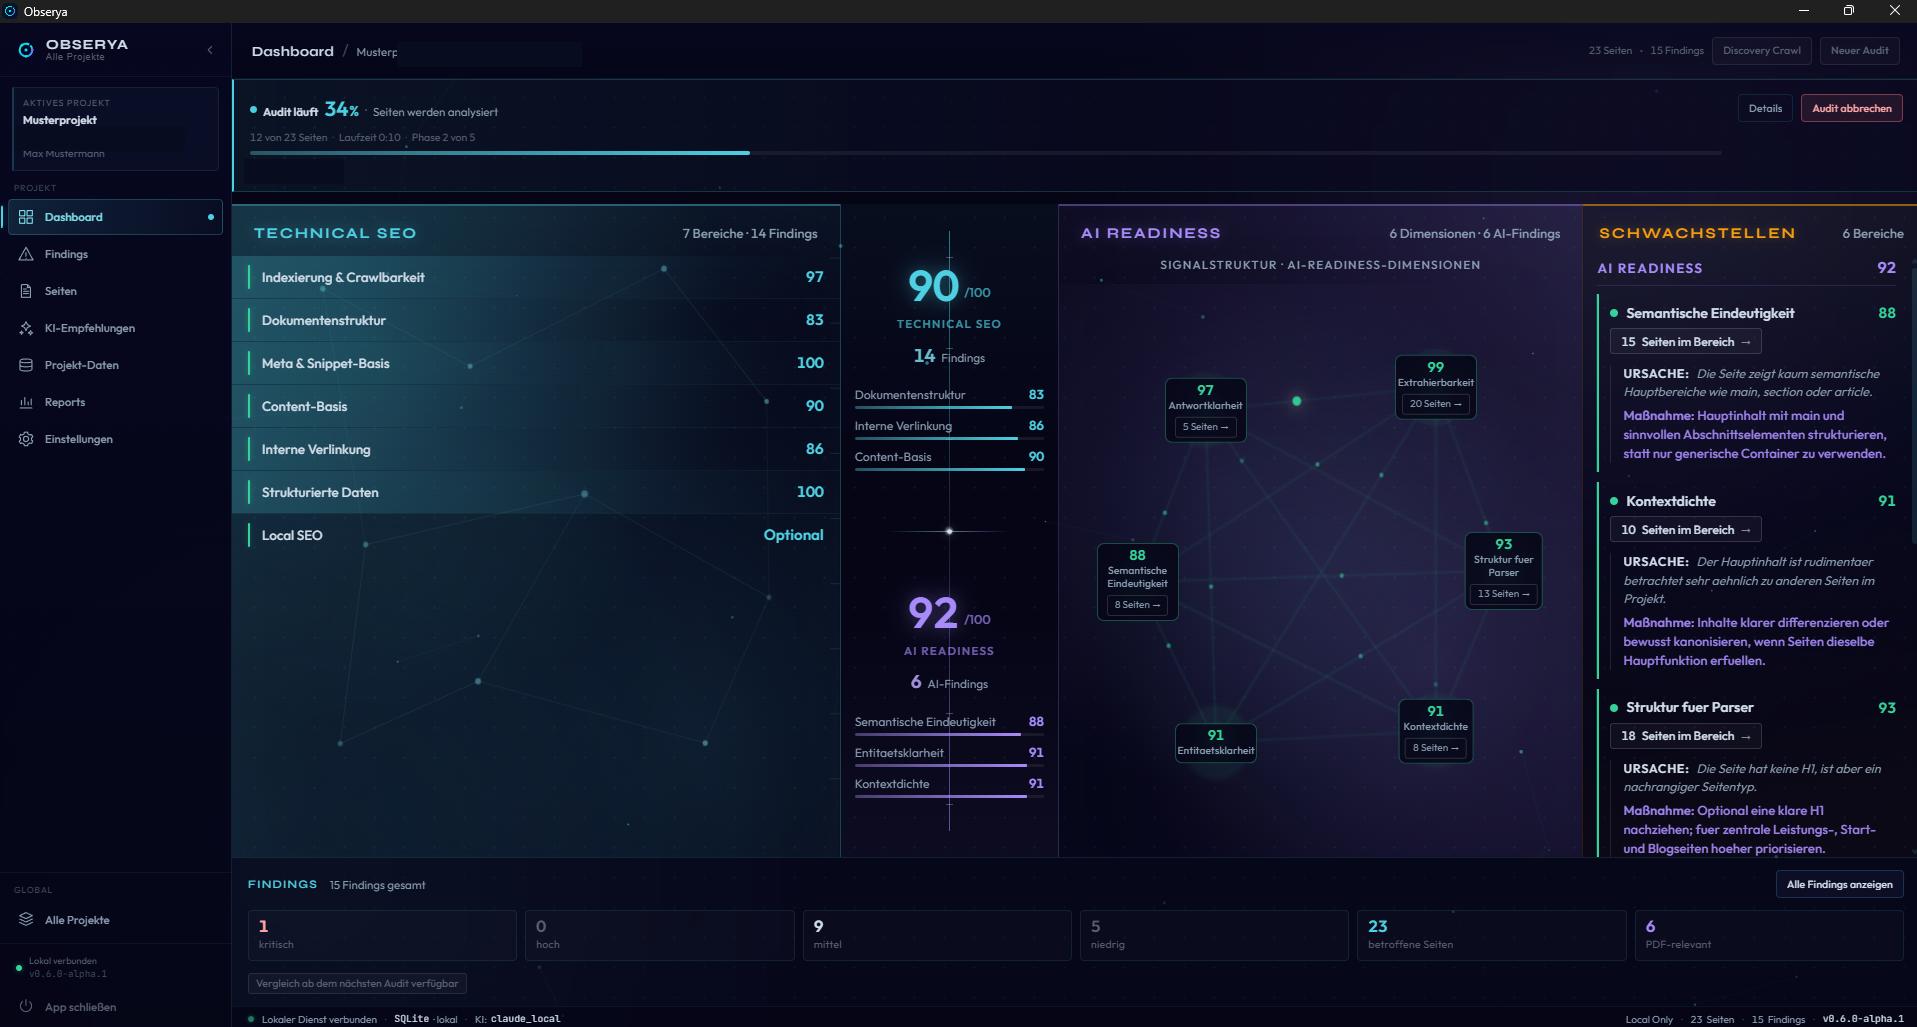
- Technical SEO und AI Readiness als getrennte Werte, ergänzt um sechs AI-Readiness-Dimensionen
- Kundenbericht als PDF sowie CSV-, JSON-, HTML-, Markdown- und Obsidian-Exporte
- lokale Windows-Anwendung ohne Cloud- oder KI-API-Pflicht für den Audit
- erste Local-SEO- und Entitätssignale
- eigener Bereich für KI-Empfehlungen: alle aktiven oder einzelne Findings analysieren, erneut prüfen und geeignete Textvorschläge kopieren
Nächste Ausbaustufe
- JavaScript-Rendering als verpflichtende Erweiterung der Crawl-Pipeline vor der Beta
- weitere technische Prüfungen und Validierung der AI-Readiness-Bewertung
- vollständiger Local-SEO-Analysebereich
- weitere Prüfung von KI-Empfehlungen, Oberfläche und Berichten
- Installer, Signierung, Updateprozess und verlässliche Projektverwaltung
Warum ich Obserya entwickle
Website-Audits finden technische Auffälligkeiten meistens zuverlässig.
Sie melden fehlende Überschriften, zu lange Seitentitel, falsche Canonicals, Noindex-Angaben, Weiterleitungen, Bilder ohne Alt-Text, dünne Inhalte oder Probleme mit strukturierten Daten.
Diese Daten beantworten noch nicht die wichtigste Frage:
Was davon ist auf dieser Website wirklich ein Problem?
Eine fehlende Meta Description auf einer zentralen Leistungsseite ist anders zu bewerten als auf einer rechtlichen oder technischen Hilfsseite. Noindex kann ein schwerer Fehler sein. Es kann aber auch genau die gewünschte Einstellung sein.
Ein Bild ohne Alt-Text kann relevanten Inhalt zeigen. Es kann ebenso ein Favicon, Logo, Icon oder rein dekoratives Element sein. Dem Favicon einen beschreibenden SEO-Text zu verpassen, nur damit eine Warnung verschwindet, verbessert weder die Website noch die Weltlage.
Viele Audit-Tools liefern an dieser Stelle vor allem Daten. Der Nutzer muss die Meldungen anschließend selbst einordnen, zusammenfassen und für einen Kunden verständlich machen.
Obserya setzt dort an.
Das Tool soll relevante Befunde erkennen, ihren Seitenkontext berücksichtigen und zeigen, was konkret daraus folgt. Eine möglichst lange Warnungsliste ist dafür kein Qualitätsmerkmal.
On-Page-SEO und AI Readiness in einem Audit
Das technische und inhaltliche On-Page-Audit ist ein zentraler Teil von Obserya.
Geprüft werden unter anderem:
- Indexierung und Crawlbarkeit
- Statuscodes und Weiterleitungen
- Canonicals und Robots-Signale
- Seitentitel und Meta Descriptions
- Überschriften und Dokumentenstruktur
- interne und externe Links
- strukturierte Daten
- Bilder und Alt-Text-Signale
- Inhaltsumfang und ähnliche Inhalte
- Seitenrollen und projektweite Zusammenhänge
Daneben steht die AI-Readiness-Analyse.
Beide Bereiche verwenden denselben Crawl und denselben Projektstand. Der Nutzer muss die Website nicht zuerst mit einem technischen Crawler prüfen, danach ein Content-Tool öffnen und am Ende noch einen separaten AI-Grader darüberlaufen lassen.
Einige Befunde berühren beide Bereiche.
Eine fehlende H1 ist ein klassisches On-Page-Problem. Sie erschwert gleichzeitig die eindeutige Zuordnung des Seitenthemas.
Ein später Antwortkern ist kein technischer Crawlfehler. Für ein Antwortsystem kann er trotzdem relevant sein, weil die konkrete Aussage erst nach mehreren Absätzen allgemeiner Einleitung erscheint.
Sehr ähnliche Inhalte können für klassische Suchmaschinen problematisch sein. Gleichzeitig fehlt einzelnen Seiten dann oft eine klar unterscheidbare Antwortsubstanz.
Obserya führt diese Informationen in einem Audit zusammen. Technical SEO und AI Readiness bleiben getrennte Hauptwerte. Es gibt keinen künstlichen Mischscore, bei dem am Ende niemand mehr erklären kann, warum eine Website 83 Punkte bekommen hat.
Eine ausführlichere Einordnung dieses Zusammenspiels steht im Artikel SEO, GEO und KI-Sichtbarkeit 2026.
Crawl, gespeicherte URLs und letzter Audit sind verschiedene Stände
Ein Crawl sammelt erreichbare URLs. Der gespeicherte Seitenbestand enthält auch URLs aus früheren Läufen. Erst der Audit bewertet die Seiten und erzeugt daraus Findings und Scores.
Ein neuer Crawl aktualisiert deshalb nicht automatisch die vorherige Analyse oder deren Bericht. Obserya zeigt den letzten Crawl, den gespeicherten Bestand und den letzten Audit getrennt. Zu einem fehlgeschlagenen Abruf gehören die betroffene URL und der Fehlergrund; die Zeitangaben helfen, die Ergebnisse dem richtigen Lauf zuzuordnen.
Sechs Dimensionen statt eines allgemeinen AI-Scores
Ein einzelner AI-Readiness-Wert erklärt wenig.
Eine Website kann inhaltlich klar formuliert sein und trotzdem eine schwache Struktur haben. Sie kann gut gegliedert sein, aber unklare Unternehmens- oder Anbietersignale besitzen.
Ein Gesamtwert zeigt dann nur, dass irgendwo etwas nicht stimmt.
Obserya bewertet AI Readiness deshalb über sechs getrennte Dimensionen.
Antwortklarheit
Hier wird geprüft, ob die zentrale Aussage einer Seite früh und verständlich erscheint.
Eine Leistungsseite sollte nicht erst nach drei allgemeinen Absätzen erklären, welche Leistung überhaupt angeboten wird. Ein Ratgeberartikel sollte die zentrale Frage nicht bis zum unteren Drittel verstecken, nur weil Einleitungen offenbar nach verbrauchter Bildschirmhöhe bezahlt werden.
Extrahierbarkeit
Konkrete Aussagen sollten sich zuverlässig aus einem Inhalt herauslösen lassen.
Kurze Antworten, Definitionen, einzelne Schritte, FAQ-Bereiche und klar getrennte Abschnitte helfen dabei. Eine Website muss deshalb nicht aus Listen und Antwortboxen bestehen. Inhalte brauchen aber erkennbare Einheiten, wenn Menschen und Maschinen einzelne Aussagen schnell erfassen sollen.
Semantische Eindeutigkeit
Thema, Überschriften und Inhalt sollten zusammenpassen.
Mehrere H1-Überschriften, widersprüchliche Seitensignale oder unklare Themenwechsel können die Einordnung erschweren.
Eine Seite über Webdesign sollte nicht gleichzeitig versuchen, SEO-Beratung, Hosting, Social Media, Branding und Unternehmensberatung als gleichwertige Hauptthemen abzudecken. Ein Mensch erkennt vielleicht noch, worum es ungefähr geht. Die eindeutige maschinelle Zuordnung wird dadurch unnötig schwer.
Struktur für Parser
Überschriftenhierarchien, Hauptinhaltsbereiche und semantische Abschnitte helfen dabei, den Aufbau einer Seite zu erkennen.
Ein Sprung von H1 auf H4 ist nicht das Ende des Internets. Er bleibt trotzdem ein unnötig unklarer Aufbau.
Entitätsklarheit
Obserya prüft, ob Unternehmen, Marke, Anbieter und Leistungen eindeutig erkennbar sind.
Dazu gehören sichtbare Angaben und strukturierte Daten. Ein Name im Logo allein reicht nicht immer aus, wenn der restliche Inhalt offenlässt, wer hinter der Leistung steht, welche Firma gemeint ist oder wie einzelne Angebote miteinander verbunden sind.
Kontextdichte
Hier geht es um den Anteil konkreter Informationen.
Allgemeine Aussagen wie „Wir bieten individuelle Lösungen für Ihren Erfolg“ lassen sich auf Webdesign, Versicherungen, Gebäudereinigung und vermutlich auch Tierkommunikation anwenden.
Viel Text ist deshalb nicht automatisch viel Substanz.
Konkrete Leistungen, Abläufe, Preise, Voraussetzungen, Grenzen und Beispiele liefern mehr verwertbaren Kontext. Wie solche Inhalte aufgebaut werden können, steht ausführlicher auf der Seite zur Texterstellung für Websites.
Die sechs Werte werden einzeln dargestellt. Der Nutzer sieht dadurch nicht nur einen Gesamtwert, sondern auch, ob die Schwäche bei der Antwortklarheit, der Struktur oder der Kontextdichte liegt.

Der Score garantiert keine Erwähnung in ChatGPT, Gemini, Perplexity oder Google AI Overviews. Ein Website-Audit kann die eigene Seite prüfen. Er kann keine fremde Antwortmaschine zu einer bestimmten Quellenwahl zwingen.
Der Seitentyp verändert die Bewertung
Jede Seite erfüllt eine bestimmte Aufgabe.
Eine Startseite führt in das Angebot. Eine Leistungsseite erklärt eine Dienstleistung. Ein Fachartikel beantwortet eine konkrete Frage. Kontaktseiten, Archive, rechtliche Seiten und technische Hilfsseiten brauchen andere Inhalte.
Obserya klassifiziert Seiten deshalb nach ihrer Rolle und berücksichtigt diese Einordnung bei der Bewertung.
Eine kurze Kontaktseite ist nicht automatisch inhaltsarm. Eine Datenschutzerklärung braucht keine verkaufsstarke Einleitung. Eine Danke-Seite muss nicht für ein wichtiges Keyword ranken.
Auch strukturierte Daten müssen zur Seitenrolle passen.
Eine Leistungsseite kann technisch gültiges Article-Markup enthalten. Der Code ist dann vorhanden und möglicherweise syntaktisch korrekt. Die maschinenlesbare Aussage beschreibt aber die falsche Art von Seite.
Obserya erkennt Leistungsseiten, die einen Article-Typ ausgeben, ohne gleichzeitig einen passenden Service-, Product- oder Offer-Typ zu besitzen. Daraus entsteht das Finding „Schema-Seitenrolle widersprüchlich“.
Ein Blogartikel darf als Article ausgezeichnet sein. Enthält eine Leistungsseite zusätzlich einen passenden Service-Typ, gibt es ebenfalls keinen Mismatch. Die Prüfung berücksichtigt den tatsächlichen Seitenkontext und verteilt keine Warnungen nach dem Prinzip: Schema gefunden, irgendetwas wird schon falsch sein.
Das wirkt zunächst wie ein kleines Detail. Genau daraus entstehen aber Reports, bei denen technisch alles vorhanden ist und trotzdem die falsche Aussage an Suchmaschinen und andere Systeme gesendet wird.

Vom Finding zur KI-Empfehlung
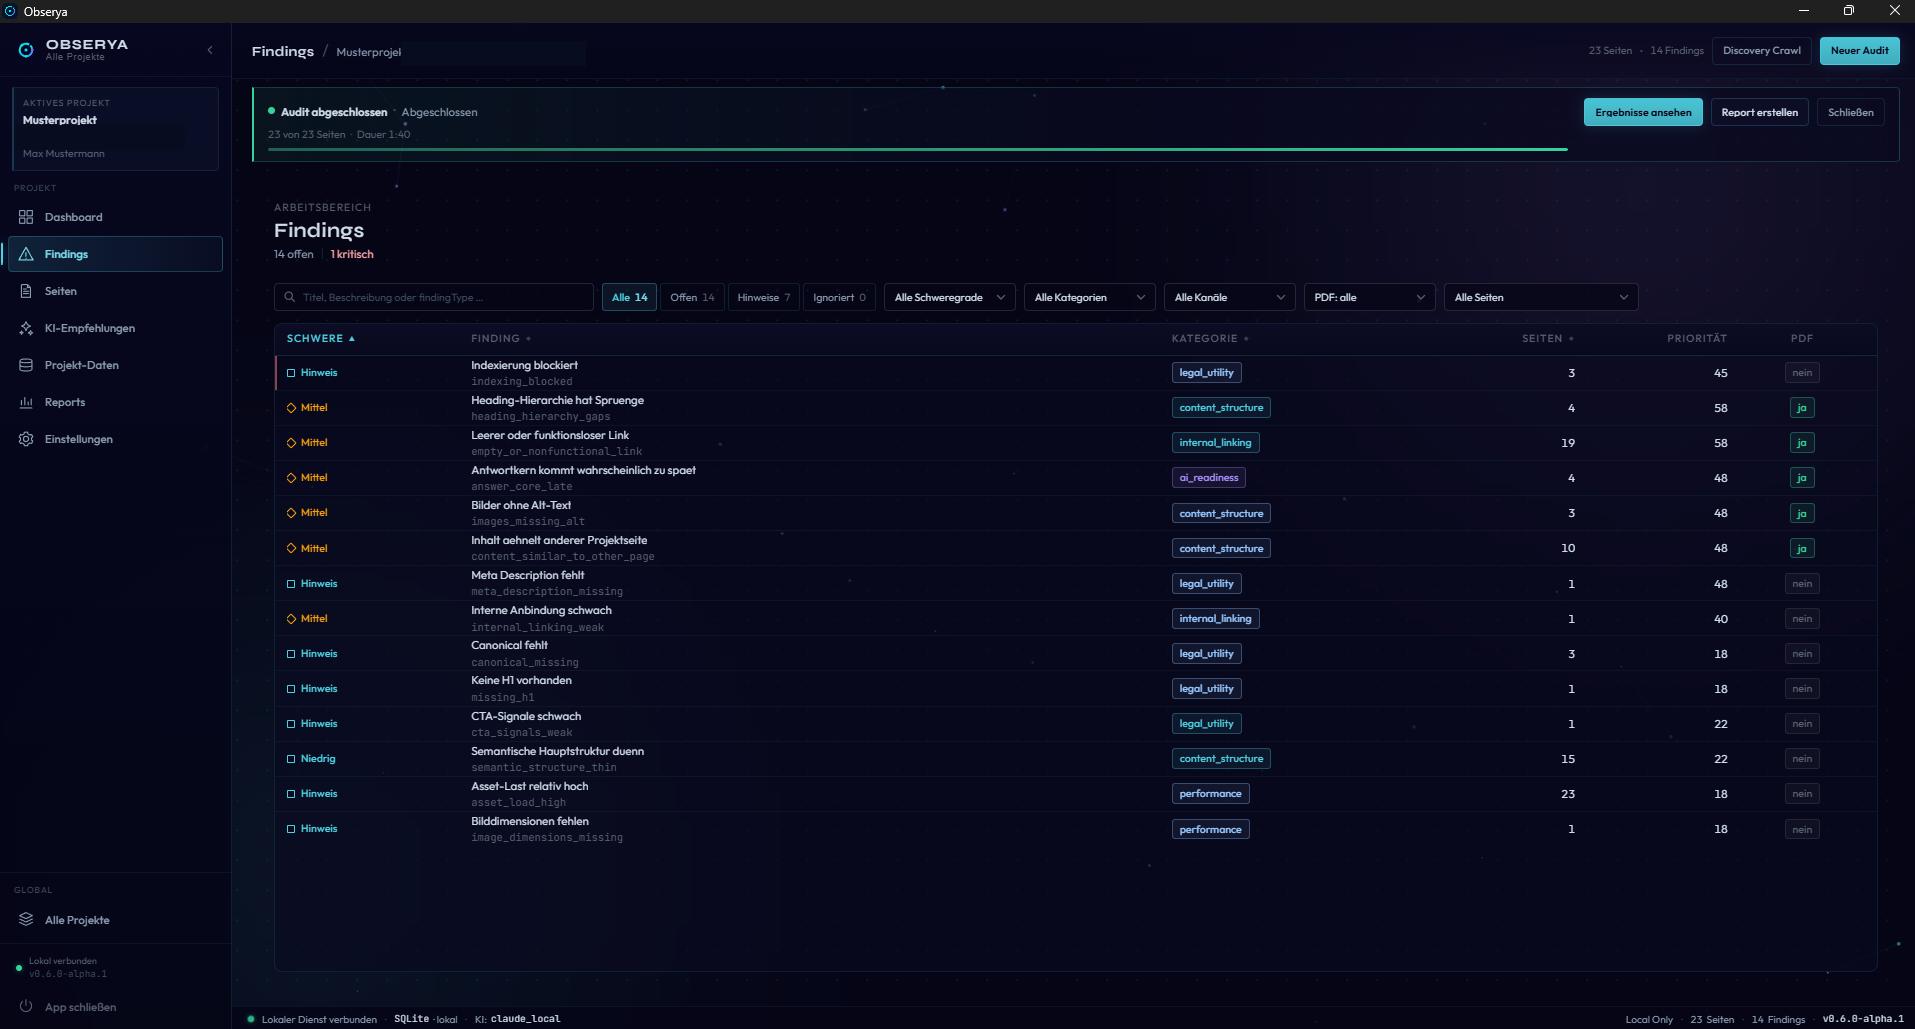
Für die weitere Bearbeitung gibt es inzwischen einen eigenen Bereich „KI-Empfehlungen“. Dort lassen sich alle aktiven Findings gemeinsam oder einzelne Findings gezielt analysieren. Eine vorhandene Empfehlung kann später erneut geprüft werden.
Zu einem Finding erscheinen Empfehlung, Begründung und Bearbeitungsstatus. Die zuletzt gespeicherte Empfehlung bleibt erhalten, wenn ein späterer Versuch fehlschlägt. Der neue Fehler wird separat angezeigt und überschreibt nicht das bereits vorhandene Ergebnis.
Bei passenden Findings und ausreichendem Seitenkontext können konkrete Vorschläge entstehen, etwa für einen Seitentitel oder eine Meta Description. Diese Texte lassen sich kopieren und vor der Verwendung prüfen. Fehlt eine belastbare Grundlage, soll daraus kein beliebiger Ersatztext werden.
Die KI ergänzt den regelbasierten Audit um Vorschläge. Sie verändert weder seine Findings noch seine Scores und schreibt auch nicht selbstständig auf der Website. Welche Empfehlung fachlich passt und umgesetzt wird, entscheidet weiterhin der Nutzer.
Dieser Ablauf ist im Alpha-Code umgesetzt. Seine technische und praktische Prüfung wird fortgesetzt.
Ein PDF für den Kunden, technische Daten für den Profi
Dieser Teil ist für mich einer der wichtigsten Unterschiede.
Viele Audit-Tools können PDF-Dateien exportieren. Das bedeutet noch nicht, dass ein Kunde mit dem Inhalt etwas anfangen kann.
Ein Rohdatenexport bleibt ein Rohdatenexport, auch wenn oben ein Logo steht und unten Seitenzahlen eingefügt wurden.
In der Praxis muss ein SEO-Spezialist solche Berichte häufig nachbearbeiten. Meldungen werden sortiert, Fachbegriffe erklärt, irrelevante Warnungen entfernt, betroffene Seiten ergänzt und technische Befunde in konkrete Aufgaben übersetzt.
Inzwischen wird der Export gern noch durch eine KI geschickt, damit daraus ein lesbarer Kundenbericht entsteht. Effizient ist anders.
Der PDF-Bericht von Obserya ist direkt für den Kunden gedacht.
Er beginnt mit einem Kurzurteil, den zentralen Scores und den wichtigsten nächsten Schritten. Danach werden die Ergebnisse nach Status, Priorität und Umsetzbarkeit eingeordnet.
Der Kunde sieht:
- welche Seiten betroffen sind
- warum ein Punkt relevant ist
- was belastbar bestätigt wurde
- was vor der Umsetzung noch geprüft werden sollte
- wie hoch Aufwand und Wirkung sind
- wer die Aufgabe übernehmen sollte
- welcher erste Schritt sinnvoll ist
Eine fehlende H1 wird nicht nur als „Missing H1“ ausgegeben. Der Report zeigt die betroffene Seite, erklärt die Funktion der H1 und nennt eine konkrete Umsetzung.
Auch Unsicherheit bleibt sichtbar.
Ein teilweise belegter Befund wird im Bericht von einem belastbar bestätigten Befund unterschieden. Hinweise, deren Grundlage für eine konkrete Umsetzung noch geprüft werden muss, bleiben als Prüfbedarf erkennbar. Das gilt beispielsweise für ähnliche Inhalte: Eine mögliche Ähnlichkeit ist noch kein fertig belegter Auftrag, eine Seite zu löschen oder zusammenzuführen.
Das ist weniger spektakulär als ein rotes Warnsymbol. Dafür muss der Kunde nicht für Probleme bezahlen, die nach zehn Minuten Prüfung gar keine sind.
Auch bei Weiterleitungen trennt der Bericht beobachtete Daten von offenen Punkten. Ausgangs- und Ziel-URLs, Weiterleitungsketten und Statusangaben erscheinen nur so vollständig, wie sie im gespeicherten Audit vorliegen.
Diese Berichtskorrekturen wurden am 4. September 2026 anhand realer Exporte aus gespeicherten Analysen geprüft und für diesen Umfang abgenommen. Damit ist weder jeder denkbare Website-Fall geprüft noch eine öffentliche Produktfreigabe verbunden.
Die technische Tiefe bleibt erhalten
Die Kunden-PDF enthält bewusst nicht jede interne Kennzahl und jedes technische Detail.
Für SEO, Webdesign und Entwicklung stehen zusätzliche Exporte bereit. CSV und JSON enthalten Findings, URLs, vorhandene Statuswerte, Fundstellen und Score-Daten. Der HTML-Export bietet eine druckfähige Berichtsversion. Markdown und der lokale Obsidian-Export unterstützen die weitere Dokumentation.
Für Weiterleitungen gibt es eine eigene CSV-Datei. Sie enthält die bekannte Ausgangs- und Ziel-URL, die gespeicherte Kette sowie beobachtete Statuscodes. Fehlen solche Daten in einer älteren Analyse, bleiben die entsprechenden Werte leer oder werden als unbekannt gekennzeichnet. Ob eine Weiterleitung dauerhaft oder vorübergehend ist, wird nicht aus ihrer URL geraten.
Der Kunde bekommt einen verständlichen Bericht mit Prioritäten und Maßnahmen.
Der Fachanwender behält die Daten für Prüfung, Weiterverarbeitung und eigene Auswertungen.
Obserya versucht nicht, dieselbe Datei gleichzeitig für Geschäftsführer, Redakteur, Entwickler und technischen SEO-Spezialisten zu schreiben. Solche Berichte enden meistens damit, dass jeder etwas anderes ignoriert.
Warum Obserya bewusst lokal läuft
Obserya ist eine lokale Desktop-Anwendung für Windows. Crawl-Daten, Findings, Scores, Projekte und Berichte werden auf dem eigenen Rechner verarbeitet und gespeichert. Für den regelbasierten Audit sind weder eine Cloud-Plattform noch eine kostenpflichtige KI-API erforderlich.
Gerade beim Datenschutz und bei sensiblen Kundenprojekten ist das ein klarer Vorteil. Audit- und Projektdaten werden nicht automatisch auf den Servern eines weiteren SaaS-Anbieters gespeichert. Dadurch verlassen weniger Projektdaten den eigenen Rechner. Webdesigner und Agenturen behalten mehr Kontrolle darüber, wo die Daten verarbeitet werden.
Dazu kommt die inzwischen übliche Abo-Sammlung. Je nach Anbieter kommen zu zusätzlichen Abonnements auch Projektlimits, Nutzerlimits oder begrenzte Kontingente hinzu.
Obserya soll keine weitere Cloud-Plattform werden, bei der jeder zusätzliche Audit, Export oder Funktionsbereich ein neues Preismodell auslöst. Der lokale Produktkern läuft auf dem eigenen Rechner.
Die optionale Claude-Anbindung nutzt eine bereits installierte und angemeldete Claude-Code-CLI. „Lokal angebunden“ beschreibt dabei den Aufruf aus der Desktop-Anwendung. Es bedeutet nicht, dass das Sprachmodell vollständig offline auf dem Rechner läuft: Die für eine Empfehlung übergebenen Inhalte werden über Claude Code verarbeitet. Der Audit selbst funktioniert ohne diese Verbindung.
Desktop-Software ist im professionellen SEO-Bereich kein ungewöhnlicher Sonderweg. Der Screaming Frog SEO Spider zeigt seit Jahren, dass lokale Anwendungen bei umfangreichen technischen Audits einen festen Platz haben.
Für Obserya ist der lokale Betrieb deshalb ein zentraler Teil des Produktkonzepts: Der Audit-Kern und seine Daten bleiben auf dem eigenen Rechner. Eine externe KI-Unterstützung wird nur bei Bedarf hinzugezogen.
Wo Obserya heute steht
Der aktuelle Stand ist eine interne Windows-Alpha. Die implementierten Funktionen werden weiter geprüft und ausgebaut. Ein öffentlich freigegebener Download oder eine abgeschlossene Beta-Reife ist damit nicht gemeint.
JavaScript-Rendering gehört zum Pflichtumfang
Der aktuelle Crawl wertet das gelieferte HTML aus. Inhalte, die eine Website erst im Browser per JavaScript nachlädt oder aufbaut, kann er dadurch nicht in gleicher Weise erfassen. Bei solchen Websites muss diese Grenze bei der Interpretation der Ergebnisse berücksichtigt werden.
JavaScript-Rendering mit Playwright ist deshalb als verpflichtender Teil der künftigen Crawl-Pipeline vor der Beta vorgesehen. Es ist noch nicht implementiert. Vorher müssen unter anderem Browser-Pakete, Größe der Desktop-Anwendung, Installation und reproduzierbare Ergebnisse geklärt werden.
Die weiteren nächsten Schritte
- KI-Empfehlungen: Den vorhandenen Ablauf mit weiteren Findings und realen Seitenkontexten prüfen, einschließlich Fehlversuchen, erneuten Analysen und der Qualität kopierbarer Vorschläge.
- Local SEO: Aus den bereits erkannten lokalen Signalen entsteht ein vollständiger eigener Analysebereich.
- Weitere Prüfungen: Der technische Audit wird ausgebaut. Die sechs AI-Readiness-Dimensionen werden mit realen Websites weiter validiert und verfeinert.
- Produkt-Finish: Oberfläche und Berichte weiter prüfen; Installer, Signierung und Updateprozess für eine verlässliche Weitergabe vorbereiten.
- Projektverwaltung: Snapshots, Versionierung sowie Projektimport und -export werden ausgebaut.
Später fest geplant
Nach dieser Ausbaustufe kommen weitere Funktionen hinzu, die Crawl-, Inhalts- und Suchdaten miteinander verbinden.
- Google-Search-Console-Daten: Suchanfragen, Impressionen, Klicks und Positionen ergänzen die Crawl-Daten.
- Kannibalisierungsanalyse: Obserya soll konkurrierende oder unnötig ähnliche Zielseiten erkennen.
- Keyword-Clustering: Suchanfragen werden thematisch gruppiert und passenden vorhandenen Seiten zugeordnet.
- Content-Briefs: Aus Audit-, Such- und Inhaltsdaten entstehen konkrete Grundlagen für neue oder zu überarbeitende Seiten.
- Migration und Redirect-Mapping: Alte und neue Crawls werden verglichen, um passende Weiterleitungsziele vorzuschlagen.
Diese Funktionen sind fest geplant, aber noch nicht Teil des aktuellen Produktkerns.
Was Obserya nicht ersetzt
Obserya konzentriert sich auf technisches und inhaltliches On-Page-SEO, AI Readiness und den Zusammenhang zwischen einzelnen Findings, Seitenrollen und Projektdaten.
Semrush deckt deutlich mehr Bereiche des SEO- und Marketingprozesses ab. Der Screaming Frog SEO Spider ist ein sehr leistungsfähiger technischer Crawler. Obserya verfolgt einen engeren Schwerpunkt.
Der lokale Audit bewertet technische SEO-Signale, Inhalte und AI Readiness gemeinsam. Kunden erhalten einen verständlichen Bericht mit Prioritäten und konkreten nächsten Schritten. Fachanwender behalten über PDF-, CSV- und JSON-Exporte Zugriff auf die technischen Details.
Dazu kommen die Seitenklassifizierung, sechs getrennte AI-Readiness-Dimensionen und die optionale Claude-Unterstützung für die Umsetzung einzelner Findings. Diese Kombination bildet den eigentlichen Kern des Tools.
Vollständige Keyword-Recherche, Rank Tracking, Backlink-Analysen und Off-Page-SEO gehören nicht zum Produkt. Auch die später geplanten Funktionen rund um Google Search Console, Kannibalisierung, Keyword-Clustering, Content-Briefs sowie Migration und Redirect-Mapping bauen auf dem analysierten Projekt auf.
Obserya bleibt damit bewusst spezialisiert. Genau darin liegt die Stärke: ein lokales Audit- und Arbeitssystem, das technisches und inhaltliches On-Page-SEO, AI Readiness und verständliche Berichte in einem klaren Workflow verbindet.
Weitere Informationen zu den klassischen SEO-Bereichen stehen auf der Seite SEO bei CoreWeb Studio. Wie AI Readiness und moderne Suchsysteme in dieses Gesamtbild passen, erklärt außerdem der Artikel SEO, GEO und KI-Sichtbarkeit 2026.
Woran ich mit Obserya arbeite
Obserya soll zeigen, was auf einer Website relevant ist, warum es relevant ist und was als Nächstes getan werden sollte.
Die Verbindung vom Befund zur Empfehlung ist inzwischen in der Anwendung angekommen. Jetzt geht es darum, sie zuverlässig zu machen und die noch offenen Grenzen des Crawls und der Weitergabe abzuarbeiten.
Daran arbeite ich gerade.
Den Produktüberblick und weitere Informationen gibt es auf der Obserya-Website.